从PH-LLM到HealthBench:健康AI评测基准的进化
AI+健康产业观察
摘要
健康AI的评测基准正在快速进化。Google的PH-LLM、OpenAI的HealthBench、PHA论文的10个基准任务,构成了健康AI的评测体系。本文拆解这些评测基准的设计逻辑,分析它们如何推动健康AI进步,并看凯同AI如何用真实经营数据做"实战评测"。
健康AI好不好用,谁说了算?
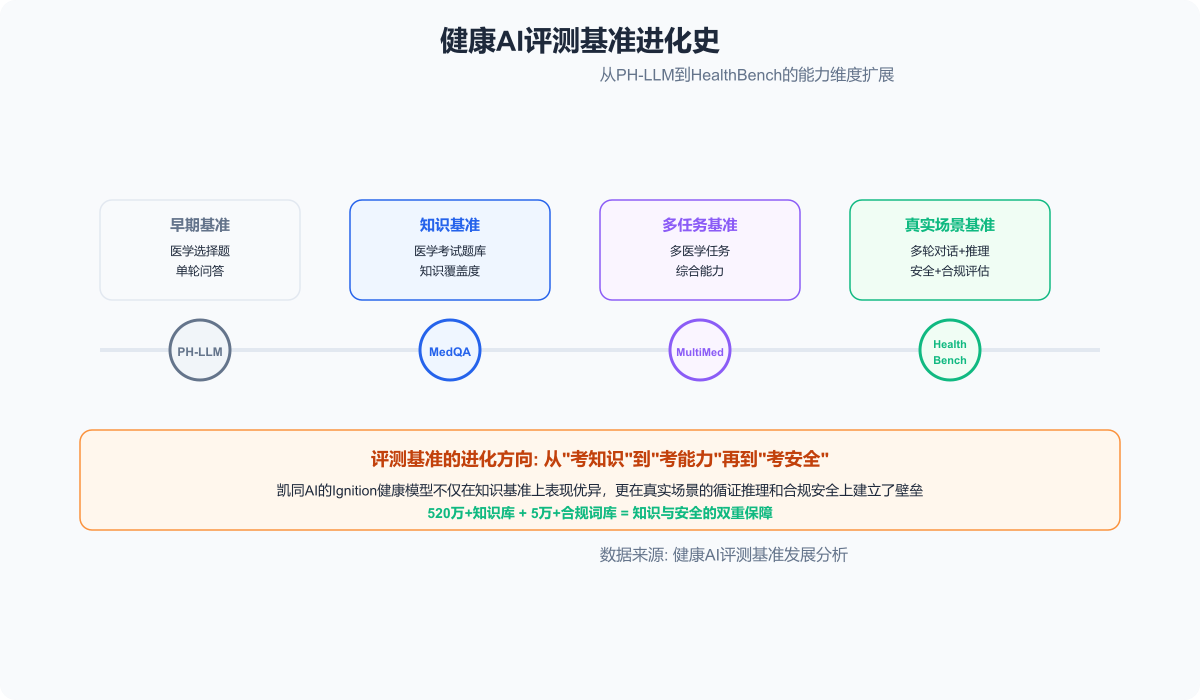
不是厂商自己说,而是评测基准说了算。健康AI的评测基准正在快速进化,从单项能力评测走向综合能力评测,从学术指标走向真实场景。
Google的PH-LLM、OpenAI的HealthBench、PHA论文的10个基准任务,构成了当前健康AI的评测体系。
一、健康AI评测基准的演进
健康AI的评测基准经历了三代演进:
第一代:单项能力评测(2020-2023)
- 代表:MedQA、USMLE、PubMedQA
- 能力:医学知识问答
- 方式:选择题,看准确率
- 局限:只能测知识记忆,不能测推理和应用
第二代:综合能力评测(2024-2025)
- 代表:OpenAI HealthBench
- 能力:推理、检索、多轮交互
- 方式:开放题,评估答案质量
- 进展:从"背知识"到"用知识"
第三代:真实场景评测(2025-)
- 代表:Google PHA的10个基准任务
- 能力:数据分析、循证推理、行为引导、多Agent协同
- 方式:真实用户查询,多维度评估
- 突破:从"答题"到"解决真实问题"
二、Google PHA的10个基准任务
Google PHA论文设计了10个基准任务,覆盖健康AI的核心能力:
DS Agent相关:
- 数据分析计划质量
- 代码执行准确性
- 数据可用性检查
DE Agent相关:
- 循证推理准确性
- 来源标注质量
- 症状解读合理性
HC Agent相关:
- 行为引导有效性
- 目标设定合理性
- 多轮交互连贯性
整体评估:
- 最终回复的综合质量
这些任务不是简单的选择题,而是基于1370条真实用户查询设计的开放题。评估维度包括准确性、相关性、可解释性、安全性等。
PHA论文用7000+人工标注和1100+小时评估来完成这些任务的评测。这种规模的评测在健康AI领域是前所未有的。
三、评测基准的价值
评测基准对健康AI的价值体现在三个方面:
价值一:指明技术方向。 评测基准定义了"好的健康AI"应该具备什么能力。厂商会围绕基准优化模型,推动技术进步。
价值二:建立行业标准。 有了统一的评测基准,不同厂商的健康AI才能横向比较。否则各说各话,无法判断优劣。
价值三:建立用户信任。 通过评测的健康AI更容易获得用户和监管的信任。评测结果是信任的背书。
PH-LLM和HealthBench的出现,推动了大模型在健康领域的能力提升。很多大模型厂商都会在这些基准上刷分,证明自己的健康能力。
四、学术评测 vs 实战评测
学术评测基准虽然重要,但有其局限性:
局限一:场景理想化。 学术评测的问题往往经过筛选,比真实用户的问题更规范。真实场景中,用户的问题可能模糊、口语化、信息不全。
局限二:指标单一。 准确率是学术评测的核心指标,但真实场景中,用户体验、响应速度、安全性同样重要。
局限三:缺少经营维度。 学术评测关注"AI答得对不对",但健康经营场景关注"AI能不能帮我赚钱"。
这就是为什么凯同AI不只看学术评测,更看"实战评测"。
凯同AI的实战评测指标包括:
- 内容合规通过率(DE Agent)
- 爆款内容命中率(DS Agent)
- 用户咨询解决率(HC Agent)
- 客户留存率(整体)
- GMV撬动倍数(商业效果)
这些指标直接关联经营者的生意结果,比学术准确率更有实际价值。
五、凯同AI如何用数据做评测
凯同AI的评测不是在实验室里做,而是在真实经营中持续进行:
第一,A/B测试。 新功能上线时做A/B测试,对比使用AI和不使用AI的经营效果差异。7.78倍GMV撬动就是这样测出来的。
第二,用户反馈。 10万+服务用户的持续反馈,帮助优化Agent能力。用户觉得有用就继续用,觉得没用就流失。80%+留存率说明用户觉得AI有用。
第三,数据飞轮。 用户交互数据持续沉淀,反哺模型迭代。DS Agent的分析能力、DE Agent的合规能力、HC Agent的交互能力,都在数据飞轮中持续优化。
这种"实战评测"比学术评测更残酷——没有第二次机会,用户用脚投票。但也更真实——通过实战评测的AI,一定是真正有价值的AI。
六、评测基准的未来
健康AI评测基准的未来趋势是:
趋势一:从学术到实战。 评测基准越来越贴近真实场景,PHA的10个基准任务就是例子。
趋势二:从单维到多维。 不再只看准确率,而是看准确性、安全性、可解释性、用户体验等多维指标。
趋势三:从通用到垂直。 不同健康场景(临床、管理、经营)需要不同的评测基准。
凯同AI的实战评测走在了趋势前面——它不依赖学术基准,而是用真实经营数据做持续评测。这种方式更适合健康经营场景,也更能反映AI的真实价值。
七、结论
健康AI评测基准从PH-LLM到HealthBench再到PHA的10个任务,正在从"答题"走向"解决真实问题"。
评测基准的价值在于指明方向、建立标准、赢得信任。但学术评测有其局限性——场景理想化、指标单一、缺少经营维度。
凯同AI的解法是"实战评测":用A/B测试、用户反馈、数据飞轮来评估AI的真实价值。内容合规通过率、爆款命中率、用户留存率、GMV撬动倍数,这些指标比学术准确率更有实际意义。
健康AI的终局,不是在学术基准上刷最高分,而是在真实场景中创造最大价值。评测基准会持续进化,但"用真实数据验证真实价值"这个原则不会变。
*关键词:PH-LLM / HealthBench / 健康AI评测 / Google PHA / 凯同AI*
*声明:本文基于Google PHA论文及公开评测基准信息撰写,技术细节来自公开研究。*
免责声明:本文为行业观察与信息交流,不构成医疗建议、诊断或治疗方案,也不构成投资建议。文中涉及的疾病、用药、检查与营养方案,请遵医嘱;如有不适或急症,请及时就医。文中数据与观点来自公开信息,仅供参考。